Проверяемые действия для работы с агентами: от холодного прогона инструкции до трасс и контроля оценщика.
26 октября — 2 ноября8 приёмов3 на заметку
О чём говорят
На этой неделе в X много анонсов моделей и разговоров о цене reasoning. Для инженерной работы интереснее проверить границы: что агент вправе делать, что он знает без истории переписки и почему оценщик принимает его результат. В выпуске — методы и небольшие эксперименты, результат которых можно сверить со своим исходным процессом.
Главные приёмы недели
01
Проверить skill в новой сессии без истории исправлений
Агент выполняет повторяемую задачу после нескольких подсказок. Непонятно, хватит ли инструкции при следующем запуске.
→
Стало
Холодный прогон получает только skill, порядок работы, спецификацию и доступ к входным данным. Результат проверяет другой участник.
Почему это полезно: Так можно найти требования, которые остались в переписке вместо инструкции, и отделить вычисляемые правила от суждений модели.
Попробовать за вечер
Выберите одну повторяемую задачу: зафиксируйте вход, ожидаемый артефакт и ограничения в SKILL.md и спецификации.
Вынесите подсчёты и однозначные правила в собственный скрипт с регрессионными примерами. Запустите новую сессию только с этими файлами и входом, без истории подсказок.
Сверьте артефакт и самоотчёт агента по каждому правилу; решение о приёмке оставьте за человеком или вызывающим агентом. Измерьте число нарушений и необходимых уточнений.
Ограничение: В статье опубликован переработанный фрагмент внутреннего процесса, а не готовый календарный проект. Нужны свои данные и проверяемые правила. Самоотчёт не заменяет проверку; улучшение автором не измерено.
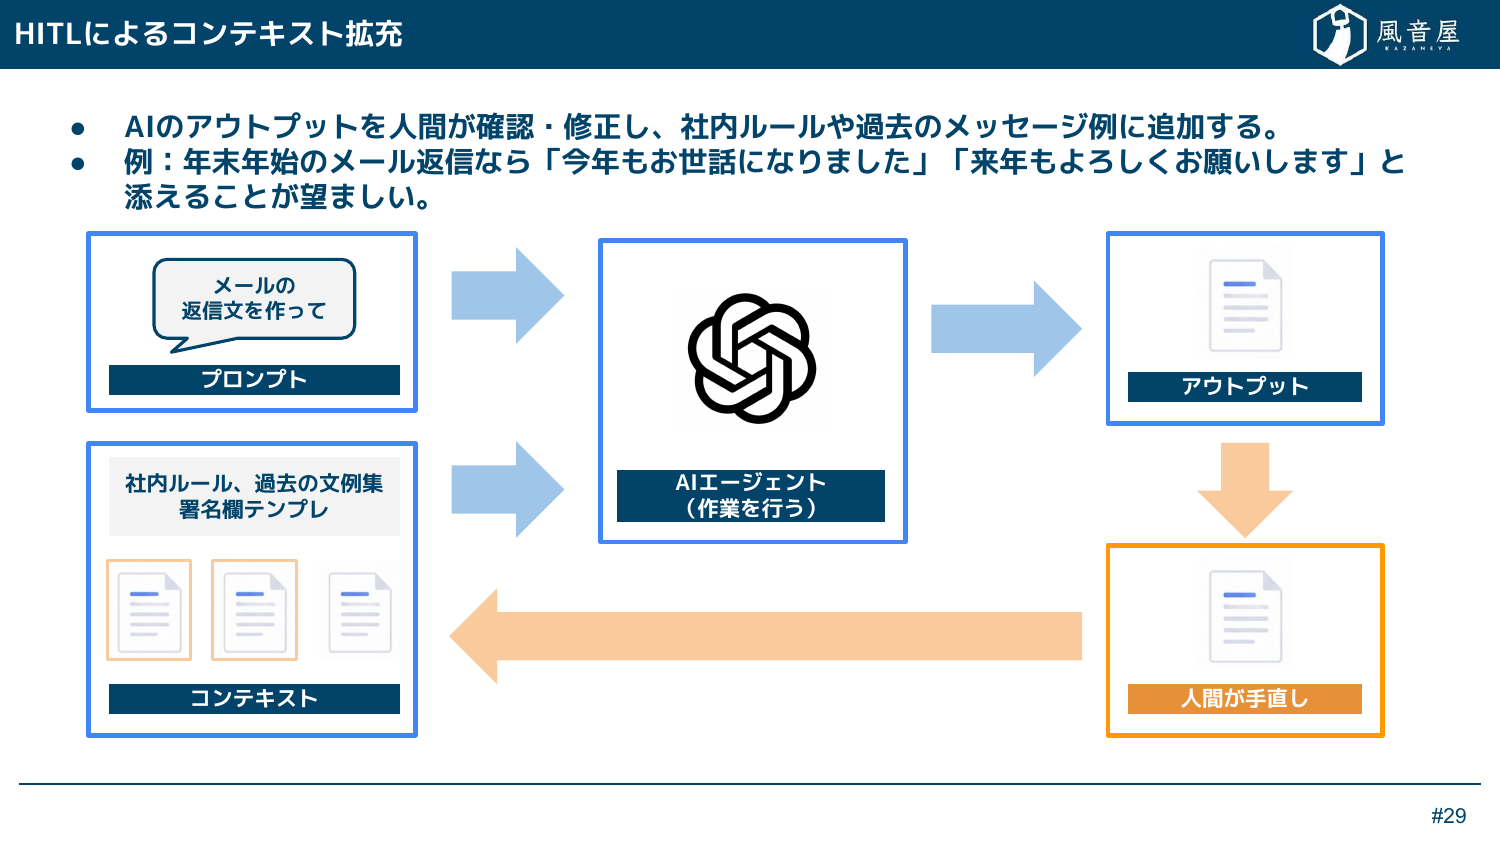
Человек проверяет и исправляет результат, затем возвращает правки в контекст агента.
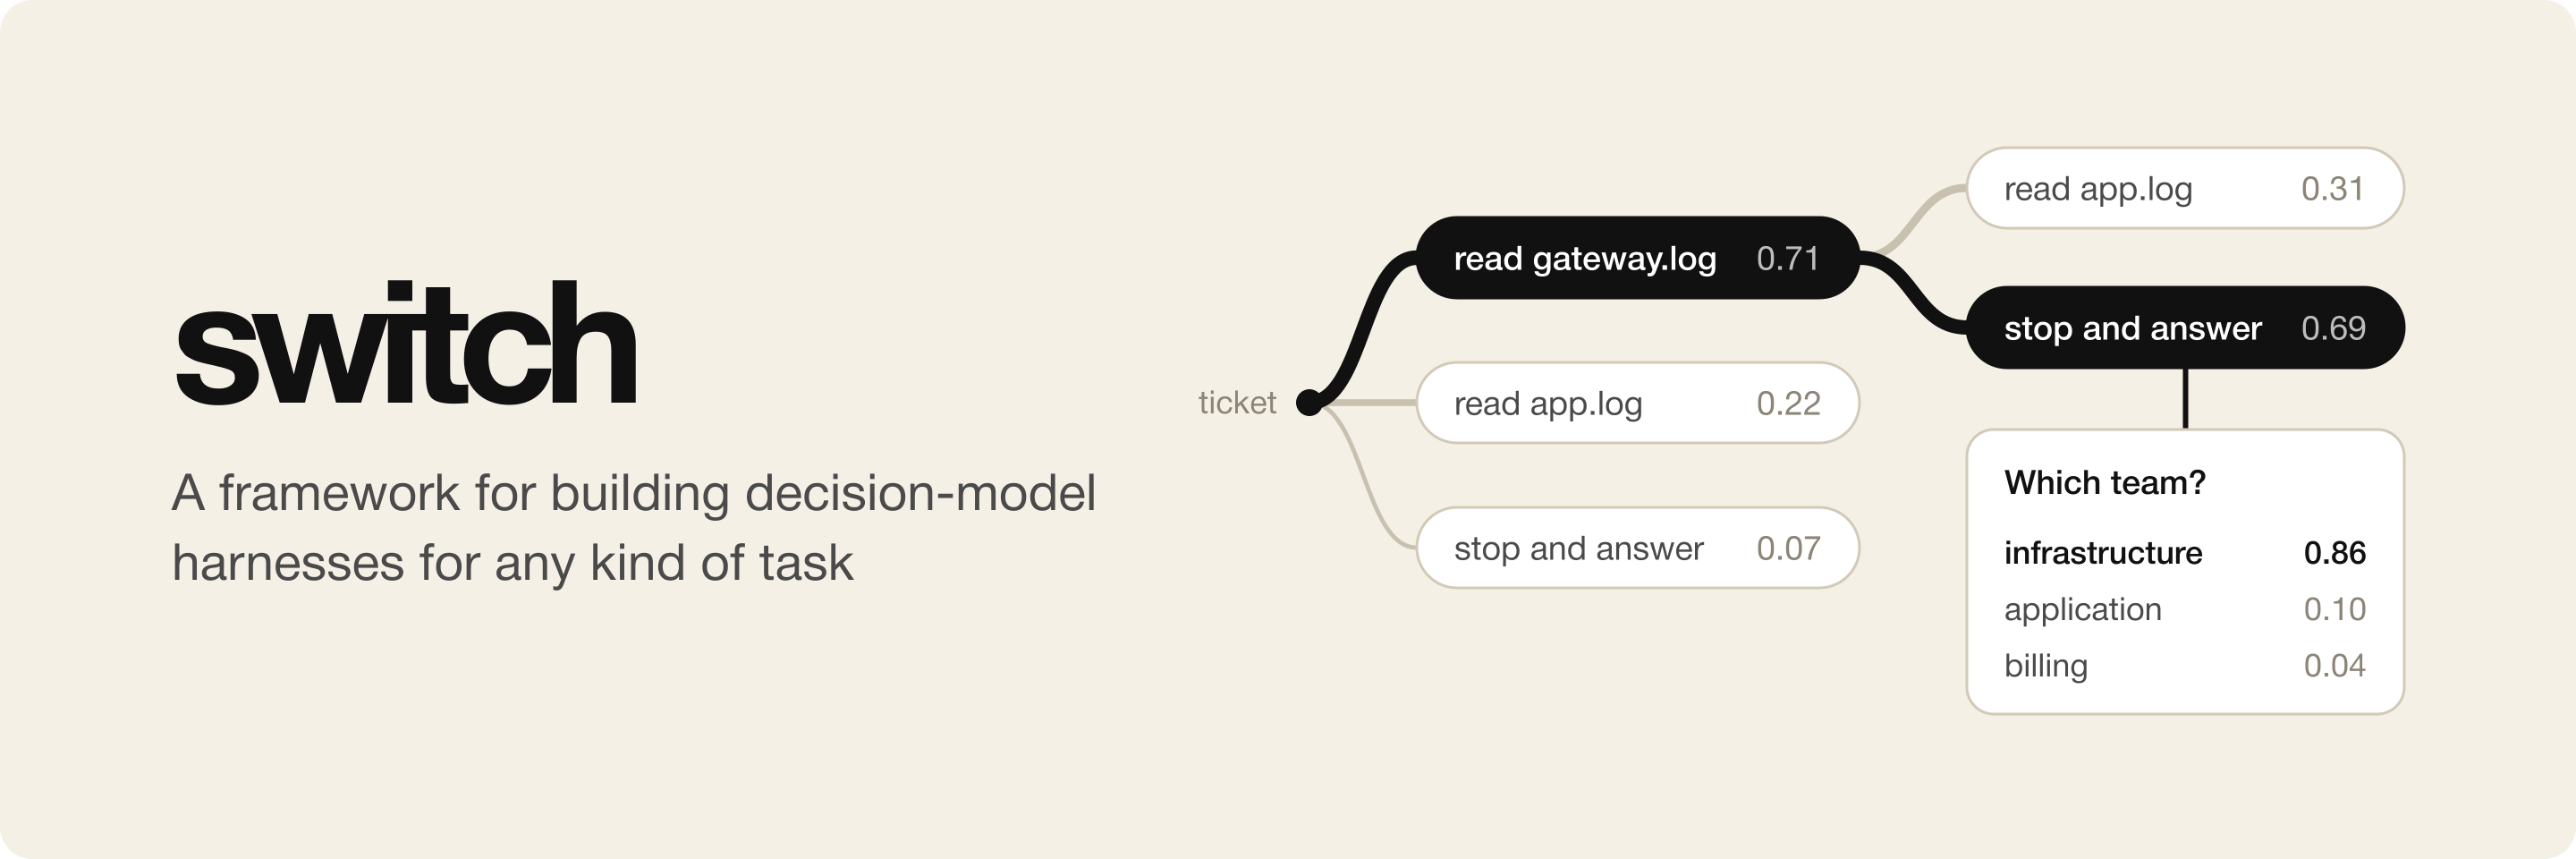
Модель сама придумывает следующий шаг маршрутизации тикета; трудно воспроизвести, почему она выбрала команду.
→
Стало
Switch задаёт допустимые действия кодом. Модель выбирает лог для чтения, остановку и команду, а трасса сохраняет переходы.
Почему это полезно: Граница между разрешённым действием и выбором модели становится явной. Трассу можно исследовать и воспроизвести без нового решения модели.
Попробовать за вечер
На Node.js 22.18+ установите пакет: npm install @osolmaz/switch. Подготовьте доступ к совместимому classifier API.
Адаптируйте triage-пример README: initial, questions, transition и view; задайте команды, логи и предел 20 шагов. Добавьте свой загрузчик тикетов.
Запустите на размеченных тикетах и проверьте trace/replay. Сравните долю правильных маршрутов, число шагов и стоимость с текущим способом.
Ограничение: Нужны свой API-ключ и небольшой загрузчик входов. Jev, по словам автора, пока не заменяет сильные модели-судьи. Экономия и прирост качества не доказаны. Примеры и viewer требуют клонирования репозитория и pnpm.
Switch выбирает следующий лог из конечного списка, затем определяет команду для обращения. Числа — пример из README.
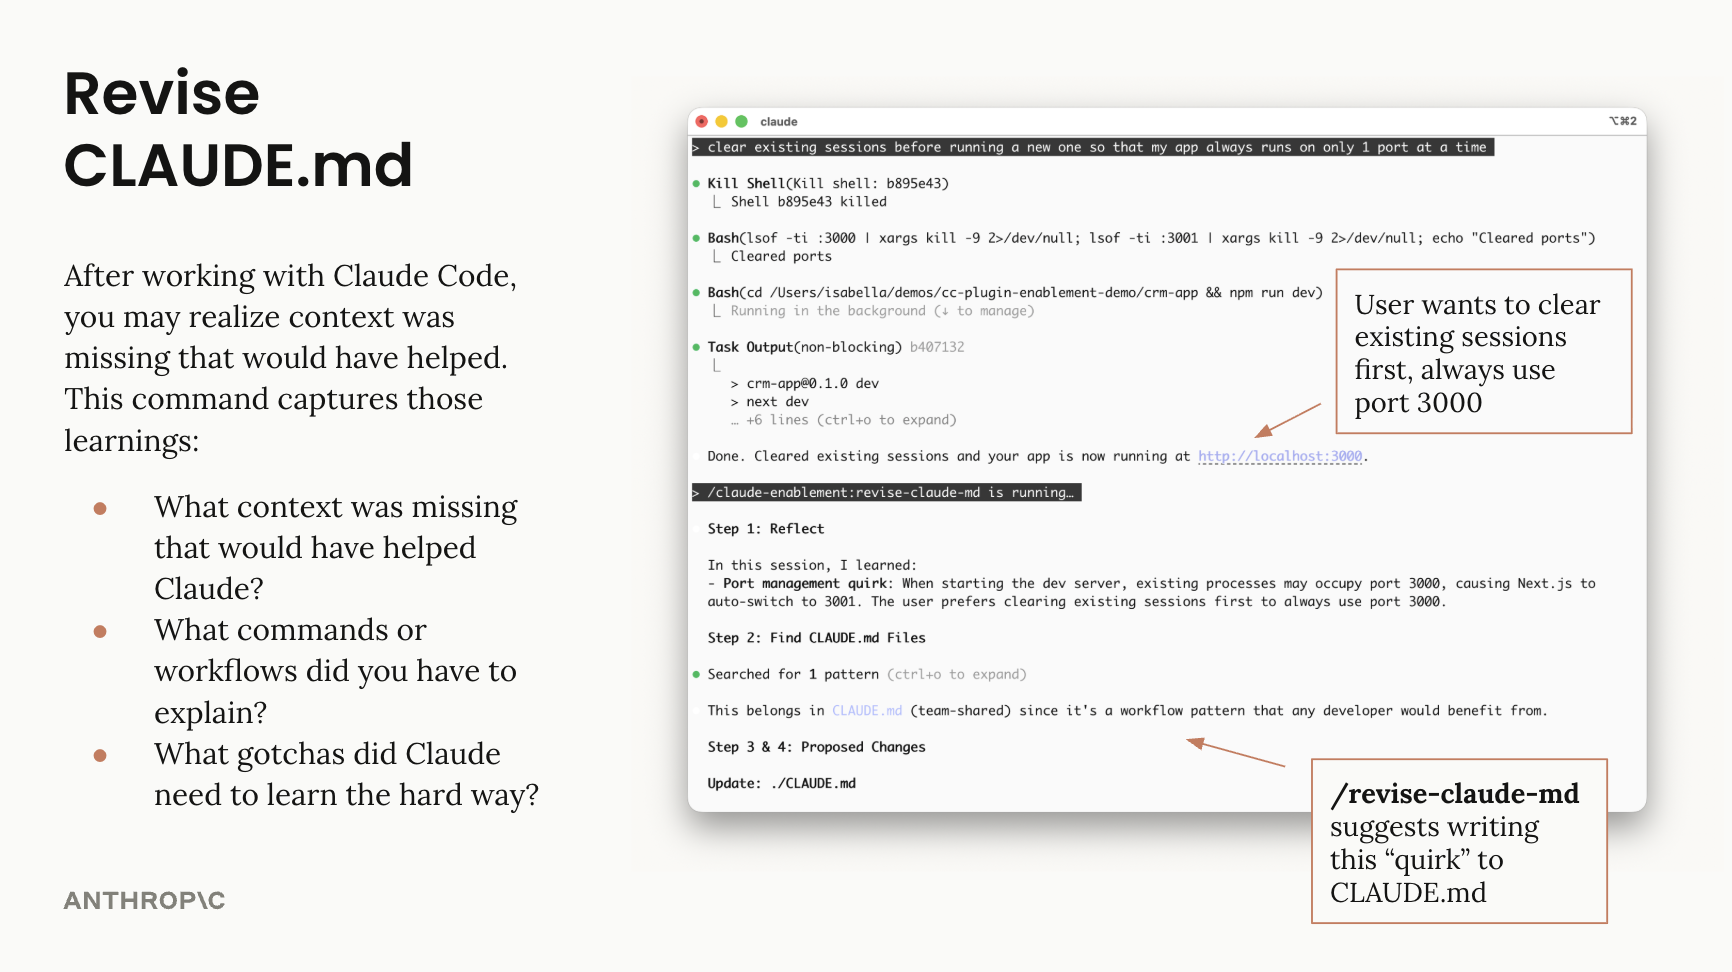
Вы снова объясняете агенту ту же особенность проекта, а CLAUDE.md постепенно отстаёт от кода.
→
Стало
Официальный плагин предлагает изменения памяти по текущей сессии; отдельный навык проверяет существующие инструкции.
Почему это полезно: Это конкретный момент для обслуживания проектной памяти: после повторившейся ошибки, пока контекст ещё доступен.
Попробовать за вечер
В Claude Code с поддержкой плагинов выполните /plugin install claude-md-management@claude-plugins-official.
После сессии, выявившей повторяющийся пробел в инструкциях, вызовите /revise-claude-md.
Просмотрите diff: оставьте проверенные факты проекта и повторяемые ограничения, уберите повторы и временные детали. На следующей похожей задаче посчитайте, какие уточнения пришлось повторить.
Ограничение: Нужны Claude Code и доступ к модели; весь процесс не объявляется бесплатным. Команда не доказывает истинность новых записей. Измеренного улучшения качества или экономии токенов в источнике нет.
Пример /revise-claude-md: замечание о запуске приложения превращается в предложение для CLAUDE.md.
Локальная модель отвечает по загруженному контексту; её способность выбирать страницы и проверять ссылки остаётся непроверенной.
→
Стало
Unsloth Desktop даёт tool-calling модели встроенный браузер и явные разрешения сайтов для небольшого исследовательского задания.
Почему это полезно: Можно проверить связку локальной модели и браузерных инструментов на одной задаче с проверяемыми фактами.
Попробовать за вечер
Установите Unsloth Desktop для своей ОС, загрузите tool-calling модель и квантование, которые помещаются в память устройства.
В обычном desktop-чате откройте меню + и включите Browser use. Поручите прочитать один публичный сайт, собрать ссылки и проверить лицензию; запретите скачивания и внешние изменения.
Сверьте факты и ссылки с исходными страницами. Запишите ошибки, пропуски и время выполнения; не переносите результат одного задания на общую автономность модели.
Ограничение: Требования к RAM/VRAM в guide не указаны; запуск 27B на любом ноутбуке не обещан. Работает собственный браузер Unsloth, только публичные HTTP(S): localhost, private network и file:// не поддерживаются. Надёжность зависит от модели.
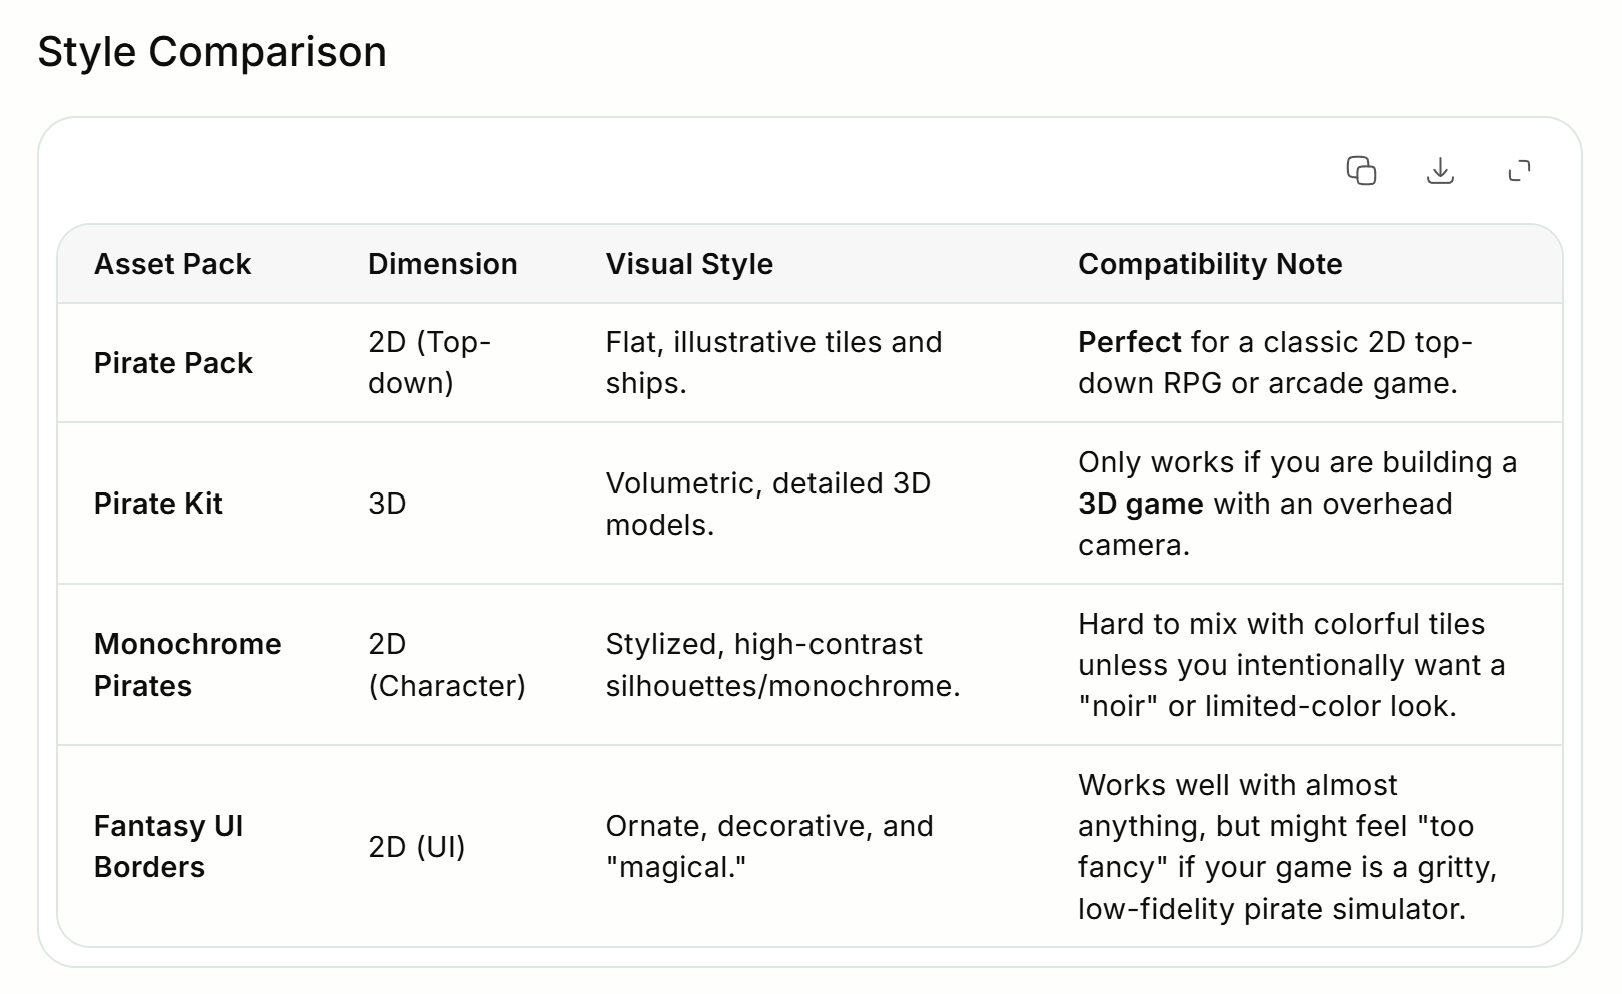
Пример результата Unsloth: таблица сравнения наборов после чтения страниц. Это демонстрация формата ответа, а не проверка его точности.
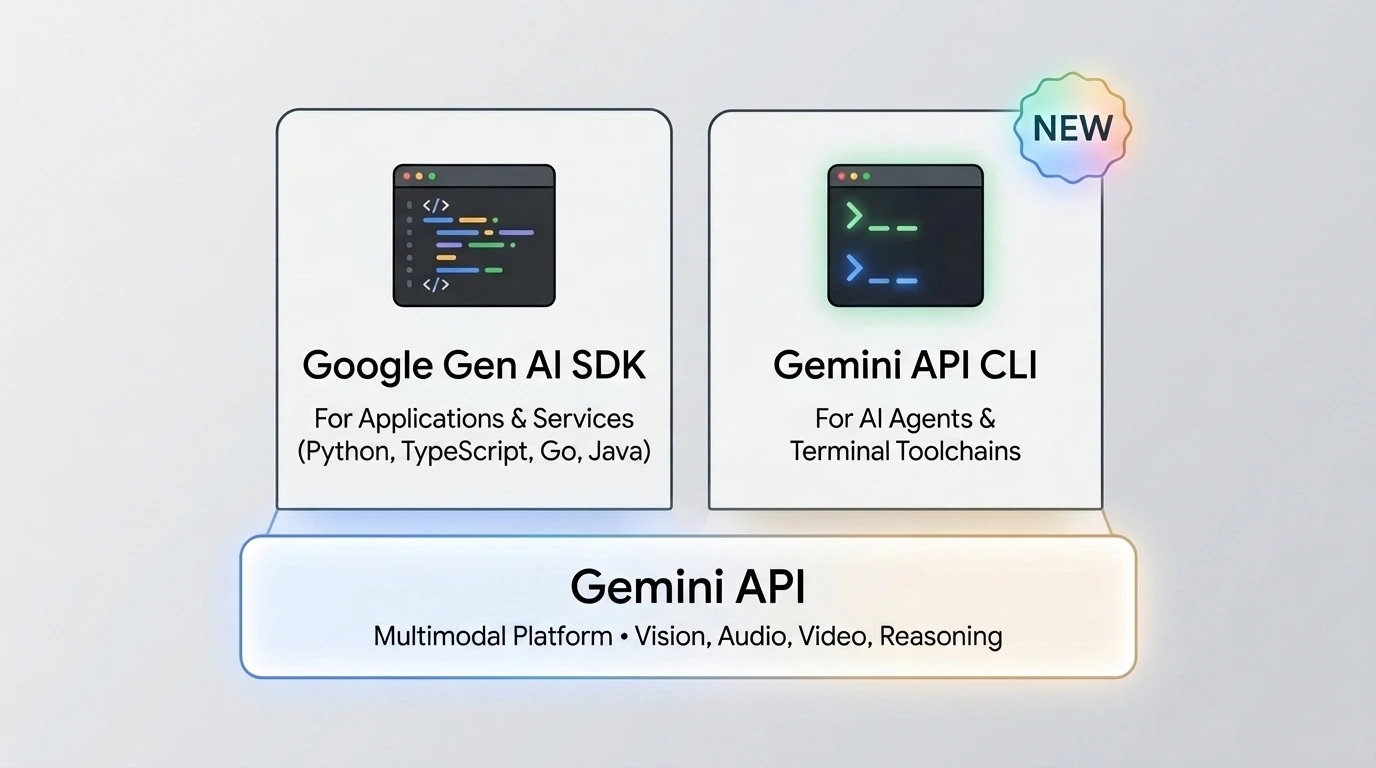
Для мультимодального API-вызова агент пишет разовый SDK-скрипт и смешивает его с планом задачи.
→
Стало
Stateless gemini-api выполняет API-вызов из shell; контекст и план остаются у существующего агента. Флаги и схему можно изучить офлайн.
Почему это полезно: Первый опыт можно ограничить одним документом, проверкой запроса и последующей сверкой ответа с PDF.
Попробовать за вечер
Установите preview CLI: go install github.com/google-gemini/gemini-api-cli/cmd/gemini-api@latest. Настройте свой Gemini API key через gemini-api configure; проверьте доступ и стоимость API.
Изучите gemini-api --help и схему нужной подкоманды. Для проверки запроса без API-вызова используйте пример: gemini-api generate "Hello from my agent" --dry-run.
На документе, который разрешено отправлять в API, выполните gemini-api analyze -i architecture.pdf "Summarize the key bottlenecks". Сверьте каждый вывод с PDF и посчитайте неподтверждённые утверждения.
Ограничение: Экспериментальная версия v0.4.x может меняться. Нужны API-ключ, доступная модель и квота; реальный анализ предполагает платное API-использование. Dry-run не анализирует PDF и не проверяет ответ. Гайд опубликован 19 октября и всплыл в ленте этой недели.
CLI и SDK используют один Gemini API: CLI — для терминальных цепочек и агентов, SDK — для приложений.
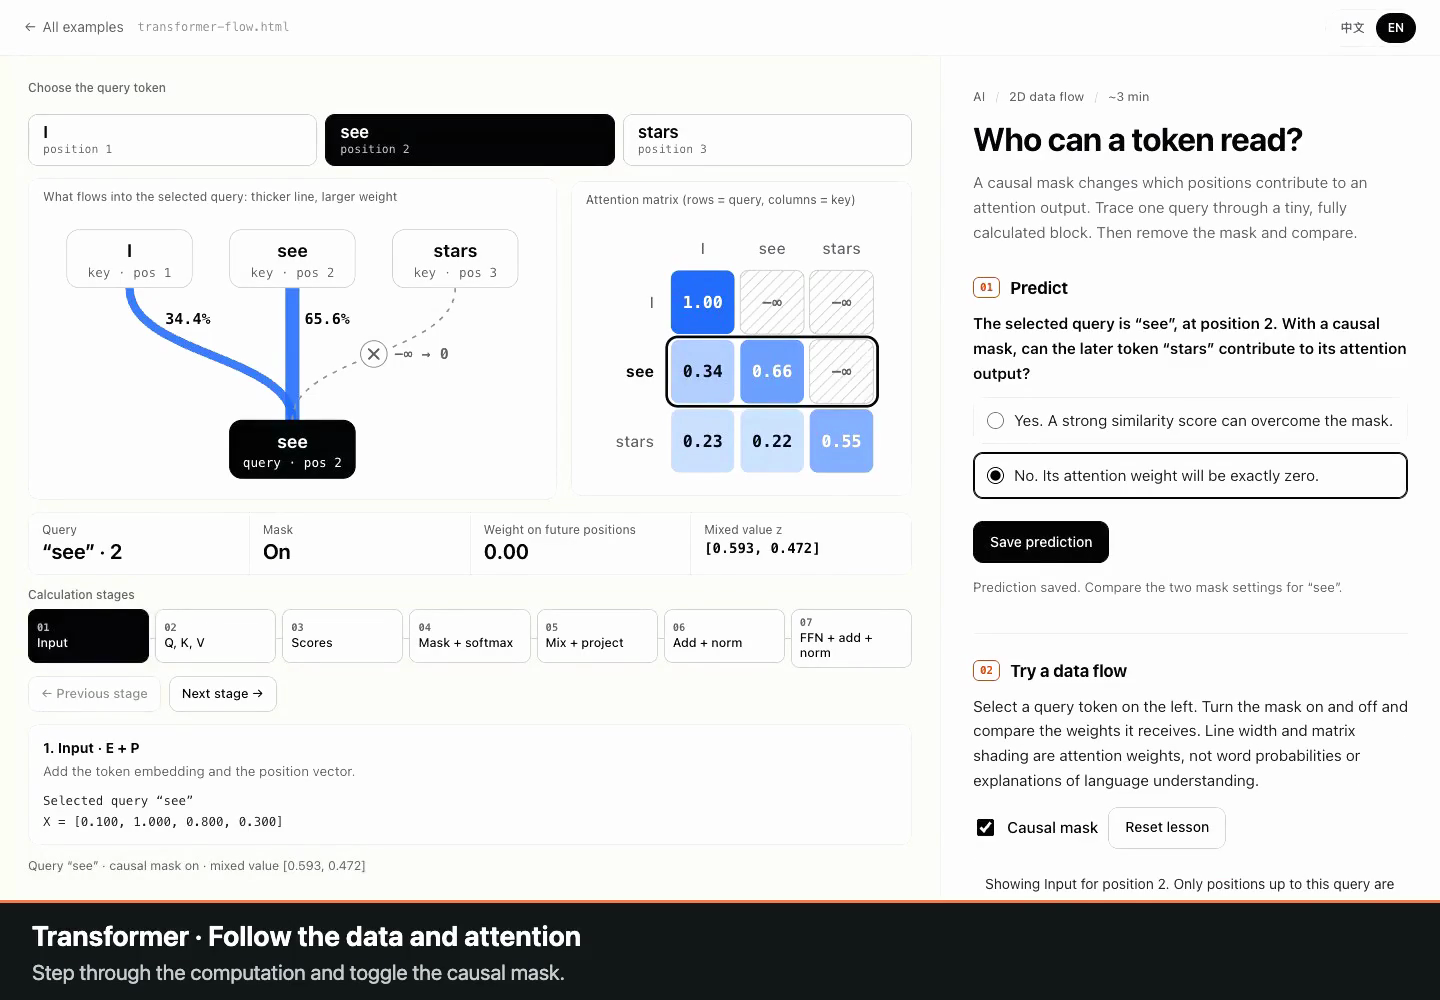
Схема Transformer показывает блоки, но не даёт проверить, что меняется при маскировании связей.
→
Стало
Teachable Figures строит отдельный HTML-урок: сначала предсказание, затем управляемое изменение и наблюдаемый результат по заданной модели.
Почему это полезно: Для разбора AI-архитектуры можно выбрать один причинный механизм и проверить численные результаты, прежде чем использовать объяснение в обучении.
Попробовать за вечер
Для Codex установите skill: git clone https://github.com/ywEdAi/teachable-figures.git ~/.codex/skills/teachable-figures.
Задайте один опыт с attention mask: аудиторию, проверяемое утверждение, типичную ошибку, управляемый параметр и эталонную модель вычислений. Попросите отдельный HTML с предсказанием, переключателем, reset и объяснением.
Сверьте численные результаты на игрушечных векторах с независимым расчётом, включая границы переключателя. Посчитайте расхождения до использования урока.
Ограничение: Это схематический опыт с раскрытыми игрушечными параметрами, а не исследование production-модели. Прохождение тестов не гарантирует правильность нового урока. Эффективность обучения не измерена; лицензии исходных иллюстраций проверяются отдельно.
Кадр демонстрации Teachable Figures: causal mask исключает будущий токен; рядом — прогноз и переключатель маски.
Одна оценка пары ответов смешивает предпочтение модели с возможной чувствительностью к позиции A или B.
→
Стало
Каждую пару оценивают в обоих порядках и сопоставляют вердикты с исходными ответами. Несогласованные случаи учитывают отдельно.
Почему это полезно: Так можно обнаружить зависимость от порядка, которую не видно в единственном сравнении.
Попробовать за вечер
Зафиксируйте вопросы, обе версии ответов, версию модели-судьи и рубрику. Содержимое ответов при перестановке не меняйте.
Оцените каждую пару дважды, поменяв A и B местами; переведите оба вердикта обратно к исходным ID ответов. Отдельно сохраните согласованные и несогласованные пары.
Сверьте обе группы с человеческими метками. Измерьте долю несогласованных пар, долю оставшихся сравнений и совпадение с метками; положительный эффект заранее не предполагается.
Ограничение: Одинаковый выбор дважды может быть ошибочным. Фильтрация скрывает потерю покрытия, если не показать отброшенные пары. Нужны два вызова вместо одного; код, готовая рубрика и измеренный прирост точности в посте отсутствуют.
Агент продолжает работать и повторять запросы; по журналу действий трудно понять, сколько полезного результата уже принято.
→
Стало
Метод babysit-runs сохраняет краткое состояние запуска, историю повторов и cooldown; проверяет содержательные выходы на ограниченном пилоте.
Почему это полезно: После перезапуска сохраняются границы работы и история восстановления. Оценка учитывает итоговые артефакты и вмешательства человека.
Попробовать за вечер
Для уже работающего runner сохраните цель, команду, владельца, артефакты, бюджет, критерий качества и границу завершения в метаданных запуска.
Проведите ограниченный пилот: проверяйте реальные выходы, сохраняйте принятые результаты и отделяйте сбойные элементы. Ограничьте повторы; сохраните retry history и время следующей попытки, чтобы пробуждение не сбрасывало cooldown.
Сравните с прежним режимом число принятых результатов за прошедший час и количество вмешательств человека. Остановитесь на согласованной границе, даже если очередь новых задач не пуста.
Ограничение: Нужны готовый runner и доступные журналы. Это инструкция по сопровождению, а не исполняемый планировщик. Источник не доказывает превосходство low effort с критикой над high effort; расходы и изменения остаются в согласованных пределах.
Уровень reasoning — переменная для собственного теста
Автор перешёл с extra high на high в Opus 5.5. Это личное наблюдение без набора задач и замеров: сравните на своих проверяемых задачах, прежде чем менять общий режим.
Разработчик Claude Code сообщает о возврате ключевого слова в CLI. Версия и точная семантика в посте не указаны; проверьте поддержку в своей установке. Измеренного выигрыша нет.
Simlock выдаёт агентам отдельные мобильные устройства
В README есть npm i -g simlock, doctor и lease. Полезно для мобильных проектов с уже настроенными SDK; iOS требует Mac. Полный жизненный цикл и освобождение устройств вынесены в отдельную документацию.
Запустить одну инструкцию с чистого контекста и посчитать недостающие требования.
ПН · 45 мин
Проверить пару ответов в обоих порядках и сохранить долю противоречий судьи.
СР · 45 мин
Провести небольшой агентный запуск с сохранённой трассой, бюджетом и границей остановки.
ПТ · 60 мин
Как собран выпуск
Окно сбора: 26 октября — 2 ноября 2026. Корпус и ранжирование сохранены рядом со страницей; полный журнал связывает рассмотренные материалы и непрочитанный резерв.
Базовый сбор дополнен авторизованным native X через Playwriter. Для коротких лент выполнена ограниченная выборка по дням до минимальной глубины skill. Это не исчерпывающий архив всех публикаций за семь дней.
Полные источники прочитаны отдельно от первичного отбора; каждый основной метод прошёл попытку опровержения. Команды подтверждены текстами авторов, но не исполнялись на проектах читателя. Результат эксперимента и доступность API нужно проверить на своей среде.
Материалы Gemini API CLI и учебные страницы могли выйти раньше: в этот выпуск они попали по публикациям X внутри окна. Основные карточки не обещают измеренного улучшения там, где источник его не доказывает.